
O que são dados estruturados e não estruturados: por que essa distinção define o que a IA consegue fazer
Quando gestores falam sobre “usar os dados da empresa para alimentar IA”, frequentemente estão assumindo que os dados existem em um formato que a IA consegue processar diretamente. Na prática, a maioria das operações industriais tem dados em pelo menos três formatos diferentes, cada um com suas próprias características, seus próprios desafios de processamento e seus próprios tipos de algoritmo adequados.
Date
03 nov 2026
Category
Software
Reading time
5 min de lectura
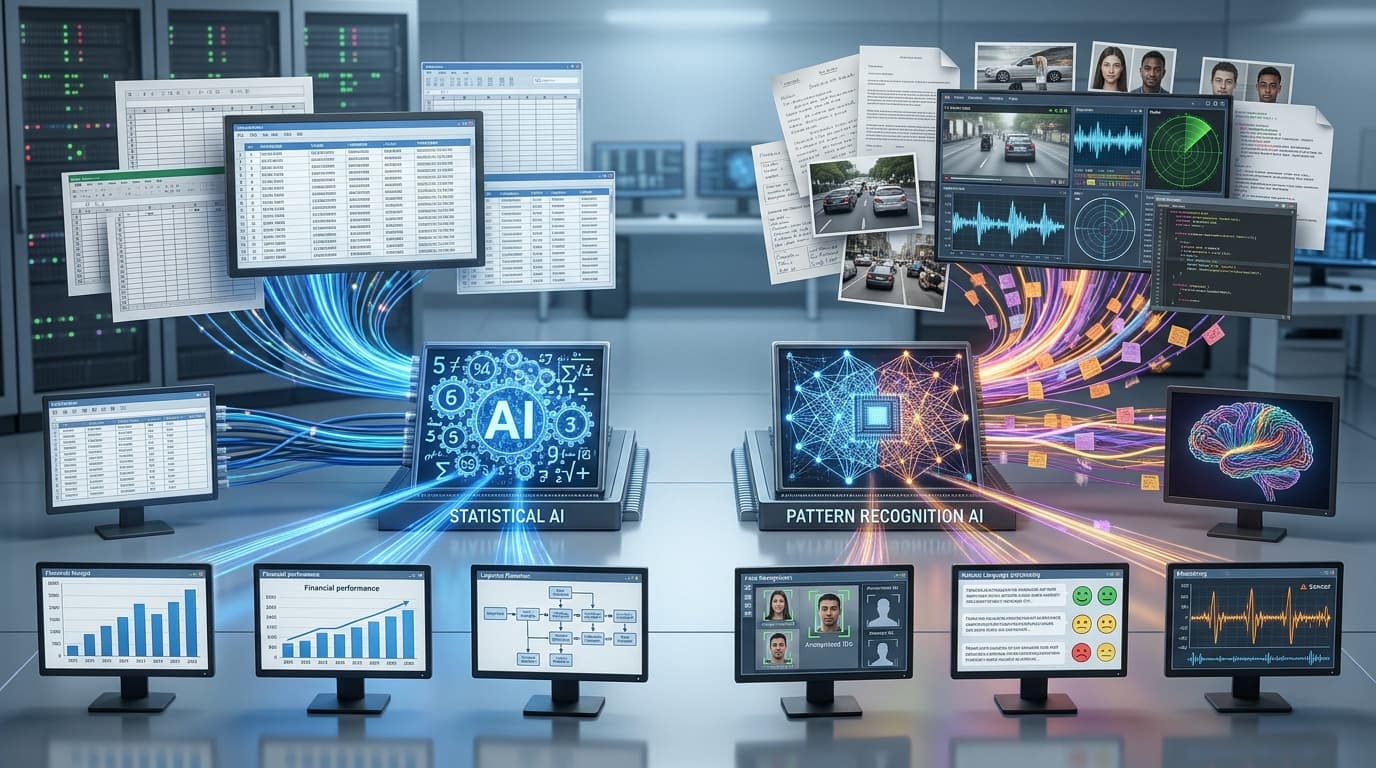
Quando gestores falam sobre “usar os dados da empresa para alimentar IA”, frequentemente estão assumindo que os dados existem em um formato que a IA consegue processar diretamente. Na prática, a maioria das operações industriais tem dados em pelo menos três formatos diferentes, cada um com suas próprias características, seus próprios desafios de processamento e seus próprios tipos de algoritmo adequados.
Entender essa distinção não é um detalhe técnico. É o que determina quais projetos de IA são viáveis com os dados que a empresa já tem, quais precisam de infraestrutura nova de coleta e processamento, e onde estão as lacunas que bloqueiam iniciativas que parecem simples mas travam na prática.
Dados estruturados: o formato que os sistemas de gestão conhecem bem
Dados estruturados são dados organizados em formato tabular, com linhas e colunas bem definidas onde cada campo tem um tipo de dado predeterminado. São o tipo que ERPs, sistemas de MES, CMMS e planilhas produzem naturalmente.
Uma tabela de ordens de produção com campos de data, equipamento, produto, quantidade planejada, quantidade realizada e status é dado estruturado. Um registro de manutenção com data, equipamento, tipo de manutenção, técnico responsável, peças utilizadas e custo é dado estruturado. Transações financeiras, registros de estoque, cadastros de clientes: todos são dados estruturados.
As vantagens dos dados estruturados para IA são significativas: são fáceis de consultar com SQL, integram com a maioria das ferramentas analíticas sem transformação complexa e suportam diretamente modelos de machine learning tradicionais para tarefas de previsão numérica e classificação.
A IBM estima que os dados estruturados representam apenas 20% de todos os dados gerados no mundo, com os outros 80% sendo não estruturados ou semi-estruturados. Fonte: IBM, 2026.
Dados não estruturados: o tipo que mais cresce e que IA sabe processar melhor
Dados não estruturados são dados sem formato predefinido ou organização em tabelas: textos livres, imagens, áudios, vídeos, e-mails, documentos PDF, registros em papel digitalizados.
Em operações industriais, volumes enormes de informação valiosa existem em formato não estruturado. Ordens de serviço com descrição em texto livre do problema encontrado pelo técnico. Relatórios de inspeção preenchidos à mão e depois digitalizados. Imagens de câmeras de produção. Registros de áudio de chamadas de suporte técnico. Manuais de equipamentos em PDF.
A boa notícia é que as mais poderosas aplicações de IA generativa e de visão computacional foram desenvolvidas exatamente para processar dados não estruturados. Modelos de linguagem processam texto. Modelos de visão computacional processam imagens. Modelos de áudio processam fala e sons de equipamentos.
A má notícia é que processar dados não estruturados com IA exige muito mais trabalho de preparação do que processar dados estruturados. Transformar um PDF de laudo de manutenção em informação que alimenta um modelo de análise preditiva requer etapas de OCR, extração de entidades, normalização de termos e validação de qualidade que não são triviais.
Dados semi-estruturados: o caso mais comum na indústria conectada
Dados semi-estruturados têm alguma organização, mas não o formato rígido de uma tabela. São o formato mais comum em ambientes de IoT industrial e em sistemas modernos de integração.
JSON e XML são os formatos mais comuns: têm hierarquia e campos nomeados, mas a estrutura pode variar entre registros. Dados de sensores industriais transmitidos via MQTT são semi-estruturados: têm campos padrão como timestamp, device_id e valor, mas os campos específicos variam por tipo de sensor.
Logs de sistemas, dados de APIs e registros de eventos de equipamentos são tipicamente semi-estruturados. A engenharia de dados industrial é a disciplina que transforma dados semi-estruturados em formatos que os modelos de IA e os sistemas analíticos conseguem processar de forma confiável.
Por que essa distinção importa para projetos de IA industrial
A distinção entre dados estruturados, semi-estruturados e não estruturados tem implicações práticas diretas para o planejamento de qualquer projeto de IA:
Estimativa de esforço de preparação de dados. Um projeto de análise preditiva que usa apenas dados estruturados de um ERP tem um esforço de preparação muito diferente de um projeto que precisa extrair informação de laudos em texto livre ou de imagens de câmeras industriais. Subestimar esse esforço é uma das principais causas de estouro de prazo em projetos de IA.
Seleção de arquitetura e ferramentas. Dados estruturados fluem naturalmente para data warehouses e modelos de ML tradicionais. Dados não estruturados precisam de pipelines específicos, armazenamento em data lakes e modelos de deep learning. A arquitetura do projeto depende do tipo de dado que vai alimentar os modelos.
Identificação de lacunas de coleta. Frequentemente, o dado mais valioso para um projeto de IA industrial não está sendo coletado de forma estruturada. O histórico de descrições de falhas está em texto livre no CMMS. As imagens de defeitos de qualidade existem em pastas sem estrutura. Transformar esses dados em ativos de IA usáveis é um projeto de engenharia de dados antes de ser um projeto de IA.
A McKinsey documenta que 80% do esforço real em projetos de IA é trabalho de dados, incluindo coleta, limpeza, transformação e estruturação. Fonte: McKinsey Brasil, 2026. O tipo de dado que a empresa tem define diretamente quanto desse esforço vai ser necessário.
Na Appmoove, a software house mais completa do Brasil, o diagnóstico de qualquer projeto de desenvolvimento de software industrial com IA inclui um mapeamento dos tipos de dados disponíveis, sua qualidade e o esforço necessário para transformá-los em formato utilizável por modelos de IA. Transformação com governança começa por entender o que a empresa realmente tem antes de comprometer com o que vai construir.
Quer entender quais dados da sua operação já estão prontos para alimentar IA e quais precisam de estruturação? Faça o diagnóstico gratuito da Appmoove. Acessar diagnóstico
Artículos Relacionados
Ver todos →
02 nov 2026
O que é cibersegurança de IA: como proteger sistemas inteligentes das ameaças que os controles tradicionais não detectam
Leer artículo →
30 oct 2026
Como a Appmoove estrutura o argumento de ROI para projetos de IA industrial antes da aprovação
Leer artículo →
29 oct 2026